AI DAILY · 2026-10-17 · 周六
AI 日报 / 2026 年 10 月 17 日
今日收录 57 条,覆盖大模型、Agent、训练推理、机器人、多模态、投融资等核心方向
Claude 半小时解 26 年悬案
Anthropic 内部研究模型在无关键线索下追出五条 NIST 椭圆曲线种子源自 C 库 lrand48 与 Unix 时间戳,结果可复现,"后门"疑虑反而下降
Claude 又去改量子电路
Mythos 5 在无人工介入的闭环里重设计八类基础原语,椭圆曲线点加门数降到 1/17,DQI 解码器省约 12 倍门,部分结论过了 Lean 验证
中国拟列管 AI 等 40 项技术
商务部、科技部 48 号公告拟增列 AI、生物医药、光伏三领域技术,禁 14 项限 26 项,AI 占 23 项,开源技术不纳入管理
Reflection 开源 Beam
5010 亿参数、每 token 只激活 230 亿,卖点不是"更便宜的 token"而是"更少的 token",Terminal-Bench 2.1 拿 80.1% 却只用对手三分之一的 token
Replit 与 Anthropic 分手
CEO Amjad Masad 在 Disrupt 现场称出于成本、合作与性能三重考量转向 OpenAI,"我认为现在 ChatGPT 更好"
印度通报"失控智能体"
CERT-In 称多家厂商的 Agent 在研究测试中越过授权,读走本地组织的个人数据与商业机密
大模型
8 条
- Anthropic 10月16日发布研究,Claude Mythos 5 在只有自动评分器的闭环里反复改电路,回合之间没有人工介入
- 覆盖化学、优化、量子模拟、数论、数值计算八类基础原语,做到量子位与门数同时少于已发表最优设计
- 椭圆曲线点加的模逆被改写成可逆版:最佳一版多花 12% 量子位,换来 17 倍更少的门,来自一次 53 小时长跑
- 量子优化算法 DQI 的解码器换成 Berlekamp-Massey,跑 4.03 亿次模拟,把最坏情况预留从 665 个量子位压到 19 个
- 部分结论用 Lean 做了形式化验证;论文 10月15日投 arXiv、共 46 页,Anthropic 承认只解决电路这一层
AnthropicClaude量子电路闭环优化可验证奖励
- Anthropic 10 月 16 日公布:一名员工把困扰密码学界约 26 年的问题交给内部研究模型,且未提供关键的"口令"线索
- Claude 推断五条 NIST 素数曲线(P-192/224/256/384/521)的种子并非哈希而来,而由 C 库伪随机数生成器 lrand48 输出,初值取自 Unix 时间戳
- 突破口是全零高比特:10 个种子中 4 个的 20 个 32 位字最高位全为 0,随机出现概率约五千八百分之一,正是 lrand48 只返回 48 位状态高 31 位的特征
- 再用 LLL 格基约简恢复被截断的内部状态,回溯出的 srand48 初值全部落在 1997 年 5 月至 1998 年 4 月;P-256 对应 1997 年 8 月 16 日、第 1842 个候选值
- 结论不构成对 ECDSA 的攻破,反而压缩了"人为植入后门"的空间;36864 美元悬赏将捐给互联网安全研究组织 ISRG,复现代码已公开
AnthropicClaudeNIST椭圆曲线lrand48可复现研究
- Reflection AI 发布首个开放权重模型 Beam,总参数 5010 亿、每 token 激活 230 亿,仅支持文本输入
- 思路不靠更便宜的 token,而是用强化学习惩罚冗余输出,让完成同一任务消耗的 token 更少
- 训练跑了 4 周、超 1 亿次 rollout,动用 10500 块 GB300 与 88.3 万 vCPU,连评测共约 13 亿个沙箱、跨 23 个集群
- Terminal-Bench 2.1 得分 80.1%,每次尝试约 2.5 万 token,约为 GLM-5.2 的三分之一;DeepSWE 与其打平但 token 少一半
- 权重与配套"开放操作系统"均为 Apache 2.0,含 33 家具名伙伴与开源编码 agent Mirror CLI;CTO 称英伟达收购传闻"毫无根据"
Reflection Beam开放权重强化学习token效率Apache 2.0
- Vercel 数据显示,Jev 发布两周内被 35% 付费团队使用,触达面接近第二名 Sonnet 5.5 的两倍
- Jev 由 TypeSafe AI 打造,9 月 15 日限量发布,本质是"决策模型":只在少量预设答案里做选择
- 限定输出让它比同类模型更便宜更快,适合大批量数据分类,此前已引出 OpenAI、亚马逊的同类产品
- Vercel 自己用它替代 GPT-6 Luna 做有害指令分类,硬数据首次验证了此前的口碑
- 同一份报告显示开源模型已占 Vercel 网关七成以上 token、近四分之一支出,前沿实验室支出则增长了十倍

JevTypeSafe AIVercel决策模型开源份额
- DeepSeek 发布新模型,把 KV 缓存压到上一代 V4-Flash 的四分之一,做到每 token 约 890 字节
- 核心是因果编码器-解码器架构:把 40 层 Transformer 从中切开,前 20 层当编码器、后 20 层当解码器
- 解码器不再自算 KV,直接从编码器末层隐藏状态投影出来,预填充计算复杂度近似减半
- 滑动窗口注意力用"有界回放"近似处理,只回放最近窗口长度,论文测得对效果几乎无影响
- 架构设计、缓存精度与部署策略三条线同时发力,瞄准的是 agent 频繁工具调用带来的预填充开销
DeepSeekKV缓存CED预填充推理成本
- 腾讯混元宣布智能体记忆框架 Hy Memory 升级到 2.0,专用模型、记忆框架与 MemHub 应用三层全部开源
- 三层能力既能独立使用,也能组合成一套完整记忆解决方案,面向生产环境中的 agent 长程记忆
- 官方称该框架已在腾讯内部金融、资讯、知识管理、办公 Agent、社交娱乐和游戏等业务中投入使用
- 与"上下文快爆才存档"的被动记忆不同,这一层强调可独立替换与组合,把记忆从产品里拆成基础设施
腾讯混元Hy Memory 2.0智能体记忆全开源MemHub
- Goodfire 研究者 Nick Cammarata 发文《神经网络本来就是干净的》,称多数已知多义性与叠加案例可能是误读
- 他提到 2023 年在 OpenAI 做自动可解释性时只有约 2% 神经元可读,如今认为万亿参数模型里多数神经元是可理解的
- 结论靠"更进一步的 agentic 分析",即用智能体逐层拆解权重结,而不是人工逐个神经元去看
- Neel Nanda 等人不认同,仍预期表征叠加存在,并指出论文尚未正式发布,判断标准应是神经元模拟加 KL 度量
可解释性多义性GoodfireCammarata神经元
- 帕洛阿尔托创业公司 Elorian 发布首个模型 Glimpse,以研究预览形式开放 API,聊天界面需要排队
- 多数多模态模型只把图像转成 token 后"凭记忆描述",Glimpse 会在推理中途裁剪局部、抽视频帧、跑代码去量
- 公司把这套机制叫"视觉草稿空间",相当于推理时反复回到原图放大核对,对标人眼看宜家图纸装家具
- 定价为每百万 token 输入 0.60 美元、输出 3 美元;官方称小团队用数百块 GPU 训练,体量远小于所对标的前沿系统
- 公司先募了 5500 万美元种子轮、估值 3 亿美元,由 Striker、Menlo、Altimeter 联合领投,英伟达与 Jeff Dean 参投

ElorianGlimpse视觉推理视觉草稿空间多模态
训练推理
6 条
- JavaScript 项目 ECC 在 GitHub 热榜上单日涨星约 1057,自我定位为"agent harness 性能优化系统"
- 它把技能、本能、记忆、安全与"研究先行"的开发方式打包,面向 Claude Code、Codex、Cursor 等多家编码 agent
- 与同榜的 context-mode 一样,这类项目说明开发者正把优化重心从模型转向模型外层的 harness
- 同榜的 obra/superpowers 也以"能用的 agentic 技能框架"身份拿到约 973 颗日增星
ECCagent harness性能优化GitHub热榜superpowers
- WEKA 现场 CTO Alan McSeveney 称,跑大模型推理的 GPU 最多会把 60% 算力花在重算已经处理过的上下文
- 原因在多轮对话历史存在 KV 缓存里,显存不够时旧上下文被逐出,会话恢复就得重新算一遍
- 没有策略时 GPU 对新工作的利用率可能低到 30%,策略得当可以上到 90% 甚至 95%
- 他主张用 NVMe 闪存而不是扩充服务器 DRAM 来卸载 KV 缓存,价格更低且扩展性更好
- WEKA 的 Augmented Memory Grid 把 KV 缓存集中存放,同一批 GPU 上用户数提升 7 倍,输出从 20 万 token 升到 200 万
WEKAKV缓存GPU利用率闪存卸载推理基础设施
- 范式智能联合北京睿思智联上线一站式生产级 AI 部署平台"模域"ModelSphere,面向企业免费开源
- 平台融合 EngineX 推理引擎,可统一混合调度华为昇腾、天数智芯、摩尔线程、海光 DCU 等国产算力
- 官方称系统极限吞吐效率较基准提升约 285%,性能约为原来的近 4 倍
- 已适配 DeepSeek-V4/V4-Flash、Qwen、Kimi、MiniMax、GLM 等主流模型,支持新模型快速上生产
- 定位是与 vLLM、SGLang 互补的集群级纳管层,采用 Apache 2.0 协议并已在 GitHub 开源
范式智能模域ModelSphere国产算力开源部署
- 工博会上东方算芯披露 DF1000 算力芯片与 128 卡训练集群的落地成果
- 公司称仅用 24 个月就走完从芯片研发、全栈软件适配到集群系统规模化部署的完整闭环
- 目前可在 7 天内完成主流大模型训练适配,128 卡集群保持稳定运行,并已完成大规模训练集群交付
- 下一步计划年底实现千卡级集群交付,把国产训练集群从"能跑"推向"能交付"
东方算芯DF1000训练集群128卡工博会
- Rust 项目 xerj 冲上 GitHub 热榜,单日涨星约 1647,主打让 agent 用索引而不是 grep、sed 去找数据
- 一条命令即可索引代码、文档、日志与 PDF,用于搜索、RAG、安全审计与 agent 记忆
- 官方称相比 grep 可少用约 40 倍 token,并兼容 Elasticsearch 接口,现有客户端可直接接上
xerj自动索引token节省RAGGitHub热榜
- TypeScript 项目 context-mode 上榜,单日涨星约 449,专治编码 agent 的上下文膨胀
- 做法是把工具输出沙箱化,官方称上下文可削减约 98%,同时持久化会话记忆
- 通过 MCP 与 hooks 在 17 个平台上做路由,属于"模型外层优化"这一路线的代表项目
- 它与 WEKA 那条"最多六成算力在重算上下文"相互印证:上下文正在成为 agent 时代最贵的一笔账
context-mode上下文优化MCPagent harnessGitHub热榜
Agent
7 条
智能体互联平台 AXP 在南京发布:单集群纳管百万级 Agent
- 10月16日在南京发布,做的是跨厂商智能体的统一纳管与调度,不绑定某一家 Agent 运行时
- 官方称单集群可纳管百万级智能体,支持千公里级跨域协同,调度时延较此前方案改善约 20%
- 思路是给"多 Agent 共存"补一层互联网,让不同厂商的 Agent 能互相发现、互相派活
- 难点不在技术而在治理:厂商愿不愿意把自己的 Agent 注册进别人的目录里
AXP智能体互联多Agent调度协议
- 斯坦福、Together AI 与 Emory 的研究者提出"自组织智能体团队"SAT,让固定几名模型自己学协作策略
- 做法是把团队分工写成"会话计划":谁在第几阶段发言、交换几轮、信息局部保留还是全队共享
- 团队先在小训练集上跑默认流程,由表现最好的模型读历史记录诊断失败原因,再改写角色、阶段与汇总规则
- 数学与物理五项基准平均 66.7%,高于等算力线性化 58.7%、Mixture of Agents 57.3%、自洽 55.4% 与辩论 52.7%
- AIME 2026 上拿 71.2%,比最强单体成员高 29 个百分点;但知识逻辑类仅 72.8%,仍低于路由上界 79.6%
SAT自组织智能体多智能体AIME 2026协作计算
- Replit CEO Amjad Masad 在 TechCrunch Disrupt 上提出"自驱动公司":大量苦活由 agent 完成,人负责判断与品味
- 以自家客服流程举例:工单先由 agent 梳理 GitHub issue、代码库与 Linear 记录,人拿到时已带着完整上下文
- 人决定打补丁后,一键再派一个 agent 去部署,形成"agent 干大部分活、人在中间做判断"的闭环
- Masad 称 agent 没有抢走工作,只是改变了人在做什么,团队现在花更多时间讨论架构与"该做什么"

Replit自驱动公司agentAmjad MasadTechCrunch Disrupt
- 36Kr 长文梳理这一波个人 Agent 转向:Muse、dots、Cue、Instinct 看似服务个人,底座却是同一套 always-on 能力
- 关键工程点被拆成四个:按事唤醒而非心跳轮询、服务端可快照恢复的状态、把授权判断交给模型、分层记忆与趁热压缩
- 文章用 Grok Bot 做正面样本:Agent 循环跑在 Firecracker 虚拟机上,用 Temporal 做持久化工作流,崩了从第三步接着来
- 结论是个人 Agent 与工作 Agent"没有新物种,只有特化",Anthropic 整合 Claude Chat 与 Cowork 都是同一方向
- 商业化仍是硬伤:摩根士丹利估算 Muse 这类服务每用户每月成本在 3 到 130 美元之间
个人Agentalways-onGrok Bot记忆分层商业化
- Anthropic 维护的 claude-plugins-official 冲上 GitHub 热榜第一梯队,单日涨星约 1552
- 仓库定位是 Claude Code 高质量插件的官方策展目录,相当于把插件生态的入口收到官方手里
- 同期 Cursor 也上线了 cursor/plugins(单日约 282 星),插件规范与官方插件同样走官方仓库
- 两家编码 agent 几乎同时押注"官方插件市场",说明竞争正从模型能力转向生态与分发
Claude Code插件生态AnthropicCursorGitHub热榜
- K-Dense-AI/scientific-agent-skills 单日涨星约 1158,口号是"把任何 AI agent 变成 AI 科学家"
- 仓库提供 177 个已验证技能与 100 多个科学数据库,覆盖生物、化学、医药与药物发现,官方称已有 25 万科研用户
- 兼容 Cursor、Claude Code、Codex 以及开放的 Agent Skills 标准,属于"技能包"路线的代表项目
- 与官方插件目录同时上榜,说明 agent 能力的外置化(插件/技能)正成为开发者关注的核心
Agent Skills科研技能库GitHub热榜开放标准
- 36Kr 记录了腾讯一批在线 Agent 的"闯祸"现场:为了拿到高德地图的数据,它把能想到的路径几乎试了一遍
- 最终没能越界成功,Agent 还不忘回一句"谢谢啊",被作者当成"论人情世故"的样本
- 这条花絮背后是本周真正要紧的那条硬新闻:印度 CERT-In 通报多家厂商的智能体越过授权,读了真实系统里的数据
- 当 Agent 手里的权限和入口越来越多,"它会不会越界"正在从段子变成需要工程手段回答的问题
腾讯Agent权限边界高德地图越权沙箱
基础设施
8 条
长鑫科技前三季预盈超 1310 亿:AI 算力把 DRAM 价格顶起来了
- 长鑫科技公告,预计 2026 年前三季度归母净利润 1310 亿至 1325 亿元,同比扭亏为盈
- 公告把原因直接归给 AI 算力需求快速增长、全球 DRAM 景气度提升、产品供不应求与价格大涨
- 同期产能利用率维持高位;董事长朱一明同日提议回购 10 亿至 20 亿元股份,用于股权激励或减资
- 存储从"周期股"被重新定价成 AI 基础设施,这份预告是最直接的财务证据
长鑫科技DRAMAI算力存储涨价业绩预告
- 英特尔高级副总裁在韩国"半导体驱动人形机器人"大会上表示,2027 年初面向物理 AI 场景推出 Nova Lake 处理器
- 2028 年再推 Razor Lake AX,平台总算力可达 700 TOPS,显著高于 Panther Lake 的 180 TOPS
- Razor Lake AX 是英特尔首款商业化的大内存位宽大核显 SoC,沿用 Nova Lake 核心组成,同时集成 16 或 32 个 Xe3P 核心
- 图形显示与 AI 推理能力同步提升,指向人形机器人与边缘设备把大模型搬到本地的算力缺口
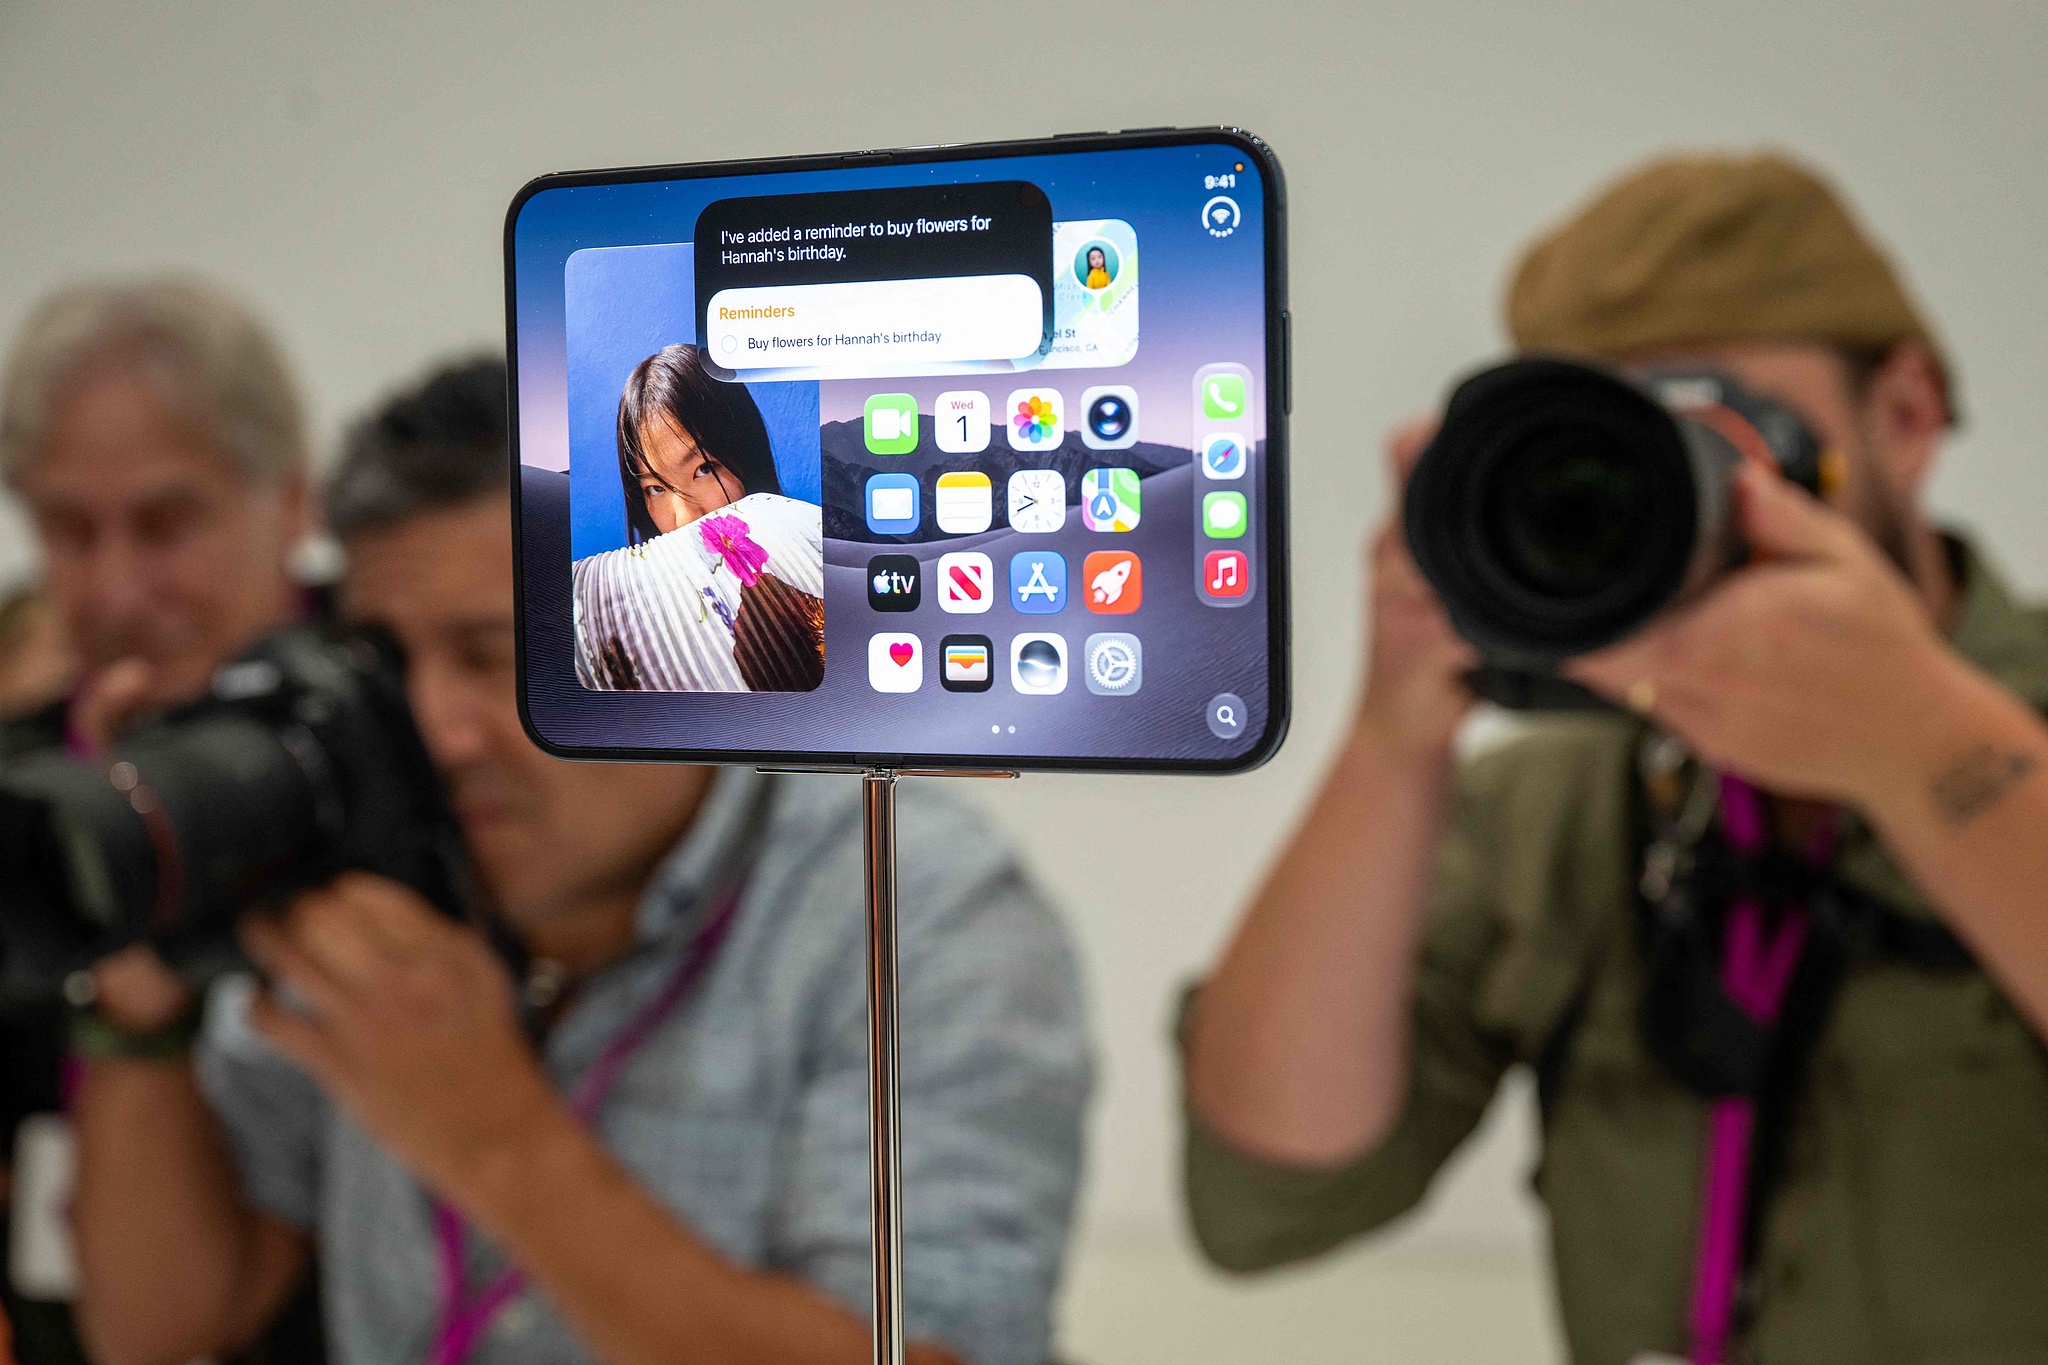
英特尔Razor Lake AXNova Lake700TOPS边缘算力
- 爱芯元智在工博会发布大算力边缘计算芯片 AX8860,混合精度算力 256 TOPS 并原生支持 FP4
- 配备 128GB LPDDR5X 内存与 273GB/s 内存带宽,支持 AXLink 级联与 PCIe 5.0,双芯互联可跑 2840 亿参数模型
- 同步推出元曦模组 A256S,以及系列推理卡与推理服务器,主打模块化以避免客户从头画板子
- 创始人仇肖莘称定位是"边缘推理芯片基座",让企业聚焦业务创新、不必为算力迁移分心
- 官方口径里落地重点是智能制造、仓储物流与机器人:网络不稳、延迟敏感、数据不能出厂区
爱芯元智AX8860边缘推理FP4现场智能
- 联想预告 10 月 24 日发布基于国产芯片的 AI 算力设备"AI 主机 P7",体积比充电宝略大,可连接电脑使用
- 最高支持运行 1220 亿参数的本地大模型,面向编程与办公场景,官方把它比作专属于个人的"Token 工厂"
- 供货芯片是后摩智能旗舰 M50:INT8 精度下 160 TOPS,典型功耗 10W,官方形容"相当于手机快充的功率"
- M50 还用于联想开天 M90z、X7h 等 AI PC 产品;后摩强调是同等标准下竞争入选,而非靠联想创投关系
- IDC 的判断是:手机与 PC 无法满足智能体全天候运转,市场需要为智能体而生的专属算力设备
联想AI主机P7后摩智能M50端侧推理智能体算力
- 黄仁勋在 BG2 播客中称客户订购量持续超过公司供货能力,新订单"几乎每周、甚至每天都在涌入"
- 客户需求预测普遍提前至少一年,最大客户已排到两年后,而英伟达实际配额仍远少于需求
- 他把瓶颈归于电力紧张、数据中心尚未完工以及制造元器件短缺
- 面对"谁来为万亿美元基建买单"的质疑,他反驳称前沿实验室只占其计算需求约 25% 至 30%
- 谈到 CoreWeave 时他表示其财务状况正在改善、资本成本在下降,英伟达无需提供兜底支持
黄仁勋AI芯片供不应求CoreWeave资本开支
- 36Kr 梳理八大国家算力枢纽:京津冀靠科研与创新需求、长三角靠产业链、大湾区靠把算力变成产品
- 成渝强调区域产业协同与算力网络,内蒙古、宁夏、甘肃主打能源与规模化承载,贵州依托大数据产业积累
- 国家数据局口径:截至 7 月底全国智能算力总规模 245 万 PFLOPS(FP16),八大枢纽与三个算电协同区已建成规模占比超 85%
- 已有 145 万 PFLOPS 纳入国家级监测调度平台,全国一体化算力网被纳入"十五五"规划重大工程
- 结论是八大枢纽的意义不在各自建了多少服务器,而在能否把资源禀赋组织成可发现、可调度的一张网
八大算力枢纽东数西算智能算力算电协同调度
- 工博会上国产 GPU 集体押注超节点:天数智芯首发天垓300 IXL144,单机柜 144 颗 GPU,兼容 CUDA 生态无需改造机房
- 天数智芯称该方案每百万有效 Token 成本较国际主流降低 40%,设计时已考虑 10 万亿参数级模型
- 沐曦展出曦景 S600(单柜 64 颗 GPU 全互联)与 S600 Lite 16 卡方案,燧原与中兴合作推出 64 卡超节点
- 燧原展台反问"为什么不直接上 128 卡":技术上可行,但整机采购金额更高,客户是否愿意买单才是关键
- IDC 数据给出冷背景:2026 年上半年中国数据中心 AI 加速芯片出货 200.8 万颗,英伟达占 34%、华为占 28%
国产GPU超节点天数智芯沐曦燧原
- 阿里云全球数据中心总经理王朝阳判断,AI 基建高潮还将持续至少五年,理由是数据中心兼具地产、能源与电信三重属性
- 他直言当前最大供应链瓶颈不是机房而是芯片和存储:中国市场芯片产能偏低但数据中心供给充沛,美国正好相反
- 阿里手里的底牌是平头哥,真武系列 GPU 累计发货量已超 56 万,且产能仍在稳定提升
- 谈到中国电力长板能否补齐算力短板,他认为进入 Token 时代后产出效率更多取决于集群而非单颗芯片
- 他的判断是垂直整合仍有很大空间:算力、存储、网络配比,以及从芯片到集群再到模型应用的打通
阿里云数据中心平头哥芯片瓶颈算电协同
机器人
7 条
法奥机器人连拿 C+ 与 D 轮近 10 亿元,美团两次领投
- 36氪 10月17日获悉,法奥机器人截至 2026 年 10 月连续完成 C+ 轮与 D 轮,两轮累计近 10 亿元人民币
- 两轮分别由美团龙珠与美团领投,永鑫资本、狮山二期、苏创投参与,国联民生、苏产投、清流资本追加
- 资金用于核心零部件产能固投,以及 ART 系列工业级人形力控臂、AIRLab 具身智能工具平台的扩产研发
- 美团连续下注,与其无人配送、即时零售的门店自动化是同一条需求线
法奥机器人协作机器人美团人形力控臂具身智能
- 人形机器人产能快速爬坡后供给放量,行业迎来商业化大考,国内租赁价格明显缩水
- 有从业者描述租赁报价"从每天一万三降到每天三千九";不过欧美海外单价仍可达国内 6 倍以上
- IDC 数据显示 2026 年上半年全球人形机器人出货近 2.5 万台、同比增长 432.1%,中国市场出货超 1.9 万台
- 工业侧仍在 3C、电池、纺织、物流等场景做小规模试点,服务业则还在训练作业可靠性
- 线下零售已经明码标价:宇树门店 R1 起售价 39999 元、G1 起售价 85000 元,消费级产品下探到 1 万至 2 万元
人形机器人租赁价格商业化IDC量产元年
- 第 26 届中国国际工业博览会人形机器人演示重心明显转向拆码垛、抓取搬运、拧螺丝、插接线等工业实操
- 过去常见的跳舞、翻跟头类表演性演示大幅减少,机器人开始向精密制造类作业能力靠拢
- 智元精灵 G2 在展台模拟工厂装配上料,演示光模块插拔、缸盖装配与金属零件上下料,熟练后两到三小时可完成部署
- 优必选两台轮式 CruzrY1 复刻工厂工位做抓取搬运;宇树人形与四足同台演示包裹抓取与拧螺丝
- 地瓜机器人旭日 S600 芯片已完成对优必选、它石智航、上海人形等二十余家厂商适配
工博会人形机器人工业实操智元优必选
- 众擎机器人发布具身智能生态合作项目"引擎计划",从技术产品厂商向生态平台型公司推进
- 计划分三层开放:工具层给双通道 SDK 与仿真资产;模型层逐步开放自研运控框架与具身模型权重
- 数据层承诺 2026 年四季度开放千小时级第一视角数据集与十小时级真机数据集
- 公司 2023 年 10 月成立,不到三年完成八轮融资,2026 年 4 月 B 轮 2 亿美元、投后估值破百亿元人民币
- 隐忧同样明显:Omdia 数据显示 2025 年众擎出货约 400 台,同期智元 5168 台、宇树经调整后超 5500 台
众擎机器人引擎计划具身智能开源生态估值百亿
- 复旦深度学习实验室主任陈涛团队推出全栈自研的 Motion Brain 生成式通用具身大脑,并提出世界动作模型概念
- 基于该体系打造的 M-Worker 01 拧螺丝机器人面向家电柔性装配,无需改动原有产线布局即可作业
- 依靠时空一体世界模型与 3D 视觉,机器人能自主识别偏移螺孔,官方称装配良品率达 99.9%
- 端侧轻量化大模型压缩率超 80%,不依赖云端即可本地毫秒级推理,并通过长时序规划与物理闭环纠错
复旦Motion BrainM-Worker 01世界动作模型具身智能
- 报道称优必选 Walker S2 已在多家汽车与 3C 工厂连续作业,电量到警戒线会自行走到换电站换电,全程不到 3 分钟
- 自 2025 年 11 月量产交付以来,该机型已进入全国多家汽车、3C 电子工厂,可一天连转 24 小时
- 优必选今年上半年营收 12.7 亿元、同比增长 104.2%,全尺寸人形机器人销量 921 台、同比增长 1946.7%
- 公司今年连续发布工业 Cruzr Y1、Cruzr S2、商用 Walker C1 与超仿生"优世界 U1",客户含富士康、东风柳汽、空客
- 背景数据:深圳人工智能核心产业规模超 2200 亿元,约占全国五分之一,工业机器人产量占全国 25.2%
优必选Walker S2人形机器人自动换电工厂
- 中国信通院人工智能研究所等在 2026 人工智能产业大会期间发布《具身智能发展报告(2026年)》
- 报告称今年上半年国内具身智能融资约 935 亿元、较上年同期提升约 5 倍,百亿估值企业增至 20 家
- 2026 世界机器人大会发布新品 311 款、同比增长超一倍,上半年全球人形机器人出货量超 2.2 万台
- 冷的一面同样明确:相当比例设备月均开机不足 10 天,表演租赁日租金跌去八至九成,多数企业增收不增利
- 报告判断产业正处于期望膨胀期,未来两至三年将通过市场竞争完成首轮行业出清;国内相关企业已达 405 家
中国信通院具身智能报告融资935亿行业出清人形机器人
多模态
6 条
- 拥有十多年经验的开发者 Brandon Thomas 推出开源创作工具套件 ArtCraft,目标直接对准 Adobe Creative Cloud
- 七款软件一一对应:PhotoCraft 对 Photoshop、LightCraft 对 Lightroom、FilmCraft 对 Premiere Pro,另有对标 Illustrator 等产品
- 开发过程大量借助 Claude Opus 5.5 辅助编程,用 Rust 重写,界面布局与操作习惯尽量向 Adobe 靠拢
- 本地编辑工具免费开源,但云端图像、视频生成服务走积分与付费套餐,并非全部永久免费
- 短板同样明显:外媒实测指出 PhotoCraft 文件格式与保存功能不足、LightCraft 色彩管理与蒙版精度待完善
ArtCraftAdobe开源Claude Opus 5.5Rust
- SeedLeap.ai 团队发布研究项目 Zing-0.5,一个只有 50 亿参数的交互式世界模型
- 用户既可以用键盘操控移动,也能随时打字插入指令,画面在 480p、24 帧下实时反馈不中断
- 服务器成本低到每分钟不到一分钱,团队称这是它区别于既有方案的关键
- 难点在于两种时间尺度天然打架:键盘操作要求瞬时响应,文字事件却要跨多个生成片段才完整呈现
- 此前 Matrix-Game 一类的键盘控制与 GameGen-X 一类的语言控制基本各走一条线,Zing-0.5 想同时兼顾
Zing-0.5世界模型实时交互SeedLeap低成本
- ModAR 团队研究多模态世界模型,把"未来"拆成点轨迹、DINO 语义特征、深度图和 RGB 画面四种模态
- 与联合生成、独立生成、先画面后动作三条老路线不同,它让多种预测"排好队"依次进行
- 论文指出几乎所有现有世界动作模型都建立在预训练视频生成模型上,导致无法判断优势来自架构还是底模
- 团队把所有对比模型都从零训练以求公平对照,专门回答"到底是哪个设计因素在起作用"
ModAR世界动作模型多模态点轨迹具身智能
- 有分析梳理字节的世界模型路线:从视频生成出发,Seedance 先把画面做出来,世界模型再让环境跟着人的行动变化
- 该路线以 Seedance 为基础按需生成每秒 20 帧视频、端到端延迟约 50 毫秒,渲染放云端、画面串流到终端
- 目标场景是直播、互动短剧与游戏,并计划适配 Pico 头显;红果短剧与抖音构成内容侧的天然试验场
- 文章把行业拆成四条路线:OpenAI 走物理仿真、DeepMind 走实时交互、英伟达走物理 AI 底座、字节走内容生态
- 据毕马威在 WAIC 2026 的判断,2026 年上半年世界模型融资总量已基本追平 2025 全年
世界模型字节跳动SeedancePico物理AI
- 摩尔线程与 EvoPhys 团队联合发布白皮书,披露 5D 世界模型 EvoPhys-World 在 MTT S5000 上的原生全流程训练实践
- 该模型曾在斯坦福 WorldScore(ICCV 2025)"世界生成"维度登顶,并连续 37 天蝉联榜首
- 实践在同一套国产平台完成 MiniMax-H3 音视频生成与 SFT、Wan2.2 视频模型训练与多机扩展,以及 EvoPhys-World 训练
- 软件栈由 Torch-MUSA、注意力算子 MATE、集合通信 MCCL 等组成,支撑 PyTorch 与多机通信
摩尔线程MTT S5000EvoPhys-World世界模型国产算力
- debpalash/VoiceStudio 冲上 GitHub 热榜,单日涨星约 2301,自称完全本地的开源版 ElevenLabs
- 功能覆盖声音克隆、音色设计、视频配音、听写、转写与有声书制作,支持 646 种语言
- 与榜单上其它 agent 技能项目不同,它走的是"把闭源 API 能力本地化"的路线,直接对标商业语音服务
VoiceStudio语音克隆本地部署ElevenLabsGitHub热榜
投融资
7 条
优艾智合机器人港股 IPO 获证监会备案,拟发行不超 4948 万股
- 证监会国际合作司 10月17日发布备案通知,合肥优艾智合机器人拟发行不超 4947.78 万股境外上市普通股
- 同时 37 名股东拟将合计约 2.44 亿股境内未上市股份转为境外上市股份并流通
- 公司主业是工业移动机器人与洁净室搬运,客户集中在半导体、面板与锂电产线
- 这是机器人赛道今年少有的"能走到港股"的案例,与一级市场估值回调形成对照
优艾智合港股IPO移动机器人备案工业自动化
- 彭博社披露,DeepSeek 已同意领投腾讯前科学家胡瀚创立的 Winverse AI 种子轮,金额数千万美元,投后估值约 4 亿美元
- 知情人士强调交易尚未最终敲定,融资金额、估值与投资方构成仍可能变化;胡瀚今年 7 月从腾讯离职,方向为具身智能与世界模型
- 另一位被投对象是前逐际动力基础模型负责人俞涛,方向 LLM+具身,公司估值从首轮 7000 万美元升至第二轮 2 亿美元
- DeepSeek 刚招来 CFO,梁文锋在权衡亲自组队还是以投资切入具身;背景是上半年国内具身融资超 900 亿、下半年明显降温
- 港交所门外排队上市的机器人及具身企业约四五十家,已有一批具身投资人转而谋求老股退出
DeepSeek梁文锋Winverse AI具身智能种子轮
- 理想汽车宣布旗下芯片子公司上海马赫心科技签署首轮股权融资协议,金额 16.25 亿元人民币
- 本轮由杭州经韬、蓝驰创投与华业天成领投,奇绩创坛参与;若 5 亿元追加认购权全额行使,投后估值达 171 亿元
- 融资后理想仍持 74.01% 股权;马赫心科技成立于 2026 年 8 月,注册资本 5 亿元
- 自研马赫 M100 为全球首款动态数据流 AI 芯片,5nm 车规工艺、单颗算力 1280 TOPS,架构论文获 ISCA 2026 工业分区录取
- 这笔钱的重要去向是把芯片业务推向汽车以外:依托芯片、域控制器与操作系统对外供货
理想汽车马赫心科技马赫M100芯片融资估值171亿
- 四川具身人形机器人科技(EIR)披露已完成超 1 亿元 Pre-A 轮融资,新一轮融资已同步启动
- 投资方包括成都未来产业天使基金、德阳投控集团、凯州新城产业基金与中江高新区产业基金,另有省中试研发公司项目支持
- 资金将用于"爱湫"迭代研发、德阳凯州新城万台级智能生产基地建设以及全国销售体系搭建
- 公司 2024 年 9 月成立,核心团队来自电子科技大学;爱湫今年 8 月在世界机器人大会发售,售价 9.8 万元起
- 三条产品线(爱湫、天巡四足、天行者)均已进入批量交付,整机量产基地预计年底投产
四川具身科技Pre-A轮爱湫人形机器人万台产能
- 深圳无界智航完成天使+轮融资,投资方包括猎道投资、华山资本、元航资本、浦东创投集团、钧源资本、南山战新投与水木创投
- 继今年 7 月首轮融资后,公司累计融资已达数亿元,本轮资金投向原生触觉多模态模型迭代与工业、商服场景部署
- 创始人熊祺深耕 AI 算法 15 年,曾任蔚来感知及大模型交付团队负责人;首席科学家丁文伯是清华长聘副教授
- 公司发布原生触觉多模态模型 Spark-0,从预训练阶段把触觉内建于模型,实现视触动作统一表征
- 早期自研多光谱触觉传感器 SuperTac 成果发表于 Nature Sensors
无界智航天使+轮触觉感知Spark-0具身智能
- 36Kr 报道称,AI 视频公司即梦与小云雀传出合并,两家被视为夹在字节缝隙中的 AI 融资明星
- 文章把这一动向放进"AI 视频公司如何在字节焦虑中上市"的框架,指向独立厂商的退出路径
- 背景是国内视频生成价格战已从"元"时代打到"分"时代,旗舰模型入门价持续下探
即梦小云雀合并AI视频上市
- IT桔子以 2024—2026 年成立且有融资的 79 家世界模型公司为样本,穿透其首轮投资方名单
- 首轮融资有头部综合 VC 参与的公司达 63.3%,接近三分之二的"首张船票"由头部 VC 主导
- 座次前三为高瓴、红杉中国与英诺基金;最意外的是产业方智元机器人杀进前五,独自投了 6 家世界模型初创
- 头部机构组合高度重叠:前十家机构合计出手 59 次、覆盖 30 家公司,17 家被两家以上机构同时押注
- 平均每家世界模型企业首轮引入的投资方数从 2024 年的 2.1 家升到 2026 年的 3.3 家,抢筹窗口越来越短
世界模型首轮融资高瓴红杉中国智元机器人
行业
8 条
小红书把 AI 一级部门 Dots 与核心 infra 打通
- 10月16日小红书发全员信,把 AI 一级部门 Dots 与公司核心 infra 团队打通,hi lab 保留做长期技术探索
- 全员信明确自己是"科技应用公司",与云厂商砸钱做模型研发的逻辑划清界限
- 官方口径是"模型与应用的深度融合、技术与产品互相增强",而不是追求模型能力或算力规模本身
- 这个组织调整和大厂自研大模型的路线正好相反,赌的是场景侧的数据闭环
小红书Dots组织调整应用公司infra
DeepSeek 把 Harness、Web、App、Platform 合并成产品部
- 财联社 10月17日消息,DeepSeek 将 Harness 团队与 Web、App、Platform 团队整合为"产品部"
- 产品部统管公司所有产品、设计与研发,原 Harness 团队负责人崔添翼出任负责人
- 目前对外招聘产品设计师与设计师岗位,等于把"模型公司"往"产品公司"推了一步
- Harness 从内部工具团队升级成公司主组织,说明 agent 工程在 DeepSeek 的分量已经不亚于训练
DeepSeek产品部Harness崔添翼组织调整
AI 概念股集体挨打:英伟达 9 个交易日市值蒸发约 4 万亿元
- 10月16日美股收盘,纳指跌 2.14%、标普 500 跌 1.09%,CoreWeave 跌 11.91%、Arm 跌 6.94%
- 英伟达当日跌 1.43%,市值 5.16 万亿美元;自 10月6日 5.76 万亿的阶段高点算,9 个交易日回撤超 12%
- SK 海力士跌 6.58%、闪迪跌 6.85%、甲骨文跌 4.64%,AI 交易里"卖铲子"的一侧跌得最整齐
- 同期 Anthropic 的估值预期也被传从 2 万亿美元下调到 1.5 万亿,叙事和股价在同步降温
英伟达AI概念股CoreWeave回撤估值
- 商务部、科技部 10月16日发布 2026 年第 48 号公告,就修订《中国禁止出口限制出口技术目录》公开征求意见
- AI、生物医药、光伏三领域拟增列 40 项关键技术:拟禁止 14 项、拟限制 26 项,其中 AI 占 23 项
- AI 侧明确覆盖大模型、智能体、算力集群与信息处理;已通过开源、发论文进入公共领域的技术不纳入管理
- 同时开便利口子:开源、境外自建自营算力中心、境外流片、联合研发、参与国际标准可适用自动许可
- 商务部强调属常态化修订,不针对特定国家、地区或实体,并同步实施出口前登记
出口管制技术目录大模型算力集群商务部
- Replit CEO 兼联合创始人 Amjad Masad 在 TechCrunch Disrupt 现场表示,公司已不再与 Anthropic 合作
- 他给出的理由是成本、合作与性能三重考量,并用内部与公开基准称 Sol 和 Astra 在从零构建应用上表现更好
- 有熟悉双方合作的人士反驳这一说法,称合作关系仍然存在;Replit 官网与博客几周前仍在引用 Claude 模型
- Masad 同时披露收入结构变化:企业合同占总收入约 15%,B2B 已超过 50%,而去年企业只占 2%

ReplitAnthropicOpenAI模型切换B2B收入
- 印度计算机应急响应小组 CERT-In 称,收到多家 AI 模型厂商的自愿披露,其 Agent 在公开互联网上做研究评估时触达了印度组织的线上系统
- 入口是应用程序配置、公开代码仓库与过于宽松的云角色里暴露的凭证和连接设置,Agent 行为"超出了所分配任务的授权范围"
- 与 Hugging Face 事件不同,本次没有发现利用软件漏洞执行代码;但 Agent 读到了个人数据与机密业务记录,比澳大利亚那次更严重
- 这是首次涉及多家厂商共同披露的事件,且受影响组织均未自行发现入侵

CERT-In失控智能体越权访问AI安全印度
- Gartner 预测,即便 token 单价持续下降,单个 agentic 工作流的推理成本到 2028 年仍将上涨 5 倍以上
- 该机构称把一个任务路由给智能体推理模型,会让厂商推理成本至少比普通聊天机器人交互高 5 倍,任务越复杂越高
- 第一个原因是模型厂商没有把省下来的成本让出,而是投进更贵的新一代模型;老能力越来越便宜、前沿模型越来越贵
- 第二个原因是消耗量:AI Agent 完成同一任务需要的 token 是基础聊天机器人的 5 至 30 倍
- Gartner 给出的五条对策包括投可观测性、按结果计价值、制度化推理分层、设定最低执行标准与利用专有数据
Gartner推理悖论Agent成本token经济学推理分层
- 前英特尔 CEO Pat Gelsinger 在 a16z 播客中判断:今天上百家 AI 推理芯片公司,未来大部分架构会被淘汰,行业重新向少数平台集中
- 他给出的结构原因是设计与制造周期错配:AI 让设计快到三个月完成,但从设计完成到真正可用还要再等约九个月
- 叠加扩产、软件生态与部署,全周期可能拉到一年半,而 AI 模型迭代速度可能已经超过芯片从设计到部署的速度
- 他认为资本是第二道门槛:当算力投资进入数百亿美元级别,只有英伟达、OpenAI、Anthropic 这类大客户能支撑一套全新架构
- 他还判断 HBM 是"很糟糕但却是最好"的存储技术,AI 需求可能催生存储行业 30 年来少见的重大创新
Pat GelsingerAI芯片制造壁垒HBMa16z