AI DAILY · 2026-10-13 · 周二
AI 日报 / 2026 年 10 月 13 日
今日收录 51 条,覆盖大模型、Agent、训练推理、机器人、多模态、投融资等核心方向
Meta 发布首个前沿模型 Muse Wonder 与 Muse Wonder Full
历时 14 个月重构后首次进入前沿梯队,官方称编程、金融、法律任务与 Fable 5.1、GPT-6 Astra 同级,主打「主动记忆」与「持续专注」
微软发布第三代自研 AI 芯片 Maia 300
台积电 N2P 多芯粒、288GB HBM4、18TB/s,每兆瓦 Token 数比主流 GPU 系统高 40%,2027 年投产并冲击数吉瓦级部署
英特尔 AI 推理 GPU 定名 D 系列并启动客户送样
32 个 Xe3P 核心、160GB 显存、350W 风冷 PCIe 卡,八卡可跑万亿参数,是 Ponte Vecchio 之后首款商用数据中心 GPU
智谱发布法律垂类开源模型 GLM-Legal
底座 GLM-5.3-Flash,HLAB 全通过率 19.2% 拿下开源权重第一、较底座提升 12.5 个百分点,单条测试成本 0.15 美元
英伟达开放 Vera Rubin 机柜设计并与思科推出 USFP 光模块
机架级盲插液冷、5000 安培母排、单柜最高 250kW;USFP 单通道 400Gb/s、单模块最高 12.8Tb/s
DeepSeek 拟领投 Winverse AI 首轮融资
金额数千万美元、投后估值约 4 亿美元,创始人胡瀚为前腾讯视觉语言与具身基础模型团队负责人,系 DeepSeek 首次下注具身智能
大模型
7 条
- 系列含 Muse Wonder 与 Muse Wonder Full 两款,全部在千兆瓦级 Prometheus 数据中心训练,官方称是「规模化阶梯的下一步」
- Active Memory 负责跨对话保留用户重要背景并主动调取,内部 MemoryBench 得分 85.6,高于 GPT-6 Astra 的 81.4 与 Opus 5.5 的 81.5
- Active Focus 强调持续推进复杂目标:尝试替代路径、绕过阻塞、依据新信息调整方案,关键动作前会先向用户确认
- 评测分三条线:法律用 Harvey's Legal Agent Benchmark、专注力用 FocusBench、长程软件任务用 SWE-Marathon
MetaMuseWonder主动记忆ActiveFocus
- 通过 Meta Model API 调用 Muse Wonder 为每百万输入 Token 4 美元、每百万输出 Token 20 美元,成本与 GPT-6 Sol 或 Opus 5.5 大致相当
- Muse Wonder Full 只面向 Muse Code 订阅者提供、不走 API,两款模型都会用于驱动 Meta 的消费级智能体 Muse
- 财联社报道用户需订阅每月 20 美元或 100 美元档位,才能在 Muse 中用到新模型,Meta 正借此开辟广告之外的 AI 收入
- Meta 称接下来会用 Muse Wonder 支撑 artifact 生成与高智能需求流程,并基于它开发面向大众的专用小模型

MetaMuseCode定价订阅
- Meta 首席 AI 官亚历山大·王在播客中称,Meta 不与同行拼编程 Agent,而是押注面向 35 亿日活用户的个人 Agent
- Muse 从 2 月原型打磨 7 个月,100 多项指标全部达标才发布,核心团队不到 200 人,官方只称用户「数以百万计」
- 他把模型研发比作「采钻石」,收益呈幂律分布,TBD 团队研究员全部直接向他汇报
Meta亚历山大王个人AgentMuse
- 报道称 GPT-6 Astra 与非职业数学家合作,完成悬置 57 年的「摆圆」难题证明,该问题属于三维非周期单铺砌方向
- 解题过程是典型的「人机混合」:由模型负责海量候选形状搜索,由数学家判断哪条路径值得继续推进
- 同期 Google DeepMind 的 AlphaProof Nexus 走 Lean 形式化验证并送同行评审,两件事形成「AI 做数学」的两条路线对照
GPT-6Astra摆圆难题形式化数学
- 中期训练扩充高质量法律语料,建立事实、法律规则与结论之间的推导关系,为长流程任务搭底座
- 后训练基于数万套真实法律业务场景做强化学习,覆盖任务拆解、思路规划与按约束条件生成交付成果
- 配套 Harness 作为运行时编排组件管理上下文、调用工具与流转执行反馈,架构与模型同步迭代
- 引入执业法律从业者的生产环境评估闭环,维度含关键争议点覆盖度、援引严谨度与下游团队二次修改工作量
智谱GLMLegalHarness法律智能体
上海 AI 实验室开源书生 SCP-Lab:统一调度异构实验设备
- 基于科学智能上下文协议 SCP 推出实验设备访问与协同协议并开源,供科研智能体统一发现设备能力、提交任务并获取反馈
- 提出 L1 至 L5 五级控制粒度,从整套实验流程细到机械臂原子动作,安全管控仍由本地系统负责
- 已在化学合成、药物筛选等 9 个场景验证;清华张数一团队借此完成上海、北京、苏州三地四节点 Cas12a 定向进化协同
上海AI实验室SCPLab科研智能体开源
- 成果发表于 Science,团队提前把解答放上网;其中两道 Erdős 问题已悬置 56 年,另证明 OEIS 整数序列库中 44 条猜想
- 还解决了一个代数几何公开问题,并改进了 min-max 优化(部分 AI 模型的训练技术)的已知界
- 系统围绕 Gemini 3.1 Pro 构建,用 Lean 起草与修订证明,Lean 每次编辑后校验、错误信息引导下一轮尝试;难题可调用 AlphaProof
- 眼下 AI 数学正处争议中:OpenAI 把数百份 AI 证明直接倒在 GitHub 而未投期刊,DeepMind 选择走同行评审

DeepMindAlphaProofNexusLeanScience
训练推理
6 条
- 研究针对自动研究型 Agent:同一任务八次独立运行最终得分从 68.3 到 100.0 不等,加大算力也补不平差距
- 把各次运行的解映射到二维图上,单次运行的解几乎总落在同一小片区域,作者称之为「想法盆地」
- 方法含两步:分叉让 Agent 裂成 K 条并行分支并各自继承工作区,冲刷让每条分支丢掉全部对话上下文、只留代码与文件
- 同等算力下 min-max 归一化平均分 0.78,单次运行 0.47、四次取优 0.54,相对提升 66.0% 与 44.4%;13 项任务中 12 项取得最高均分
- 只清空上下文而不分叉,也有约 22% 提升;归一化标准差从 0.26 降到 0.16
微软研究院ForkandFlush上下文重置Agent
- 在开放计算项目全球峰会上,英特尔把此前的 Crescent Island 正式定名为 GPU D 系列,并公开最终性能规格、同步启动客户送样
- 集成 32 个 Xe3P 核心、256 个 XMX 矩阵引擎与 256 个矢量引擎,32MB 统一二级缓存;XMX 由 Xe3 的四级脉动阵列改为十六级结构
- 自有品牌出厂 160GB、ODM 最高可配 480GB LPDDR5X,旗舰带宽 1.5TB/s(20 颗芯片、80 通道、约 9375 MT/s)
- 官方 FP8 矩阵峰值 1.3 PFLOPS,较 AMD 同属 PCIe 板卡形态的 MI350P(约 2.3 PFLOPS)低约四成
- 350W 风冷 PCIe 5.0 x16,无需液冷改造;无图形输出单元、定位纯推理,保留 4 编码器 + 4 解码器
英特尔D系列推理GPUOCP
- 采用多芯粒设计,把计算、内存控制器与 I/O 功能分开,计算芯粒基于台积电 N2P(2nm 级)制程
- 八组 HBM4 提供 288GB 容量与 18TB/s 峰值带宽,与英伟达旗舰 Rubin 容量相当,但带宽低约两成
- 关键设计是数据流架构:能用片上 SRAM 缓存就不走 HBM,必须走时优先发给物理位置更近的存储堆栈
- 支持 MXFP4 等轻量格式压缩数据,官方称「更窄的表示降低了内存占用与数据搬运,让同一功耗包络能支撑更大模型、更长上下文与更多并发会话」
微软Maia300HBM4数据流架构
- 微软称 Maia 200 已在服务生产负载,含 Microsoft Copilot 与自研 MAI 模型团队,GitHub Copilot 与 Microsoft Foundry 将在年底前跟进
- 该芯片运行 OpenAI 模型、MAI 模型与开源模型家族,正部署于美国、欧洲和澳大利亚,为 Teams、Copilot、Cowork 的内置 AI 功能提供最高 1.7 倍于主流 GPU 基础设施的每瓦 Token 数
- 微软 CEO 纳德拉此前对分析师表示,Maia 200 每美元性能比公司机队中最新一代硬件高 30%
- 微软同时与英伟达、AMD 合作训练模型,但未给出数吉瓦级部署的时间表
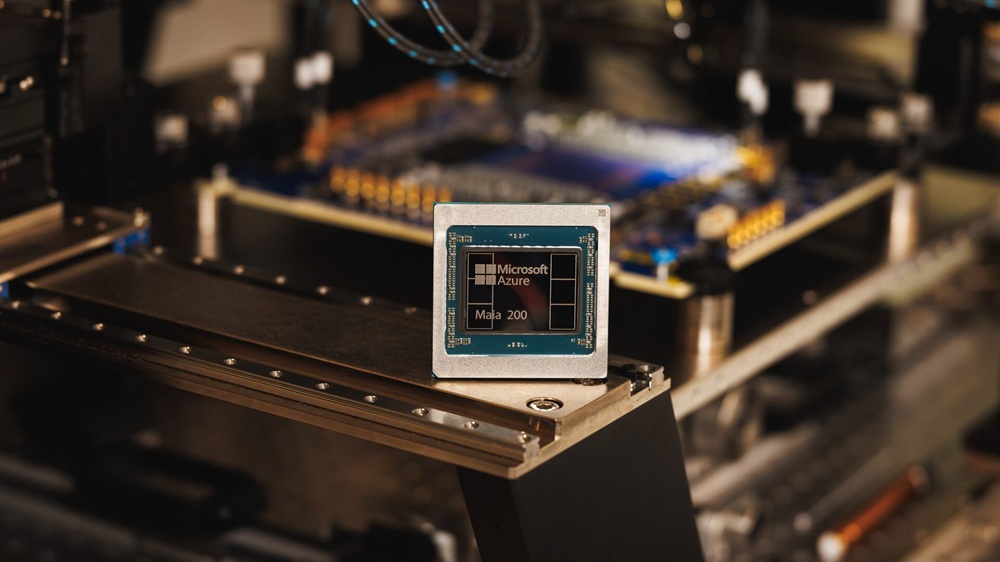
微软Maia200Copilot每美元性能
- 两家公司 CEO 均认为对算力基础设施的需求仍将持续超过供应,但资金获取能力可能成为制约 AI 热潮的一大因素
- 博通 CEO 陈福阳称,融资问题对 AI 扩张的制约甚至可能超过半导体、存储芯片或电力短缺
- 这一判断出现在 Maia 300、Vera Rubin、D 系列接连发布的同一周,供应链与资本开支的匹配问题被推到台前
博通英特尔算力供给融资
AMD 推出面向智能体 AI 的机架平台 Helion
- AMD 发布面向智能体 AI 的专用机架计算平台 Helion,把开放硬件架构与集成式模型路由能力结合
- 搭载 AMD 自研计算芯片,单机架最多支持 32768 个 CPU 核心,进一步拓展其在 AI 基础设施市场的布局
- 同期 AMD 以 82 亿美元收购李飞飞创办的空间智能公司 WorldLabs,硬件与物理 AI 两条线同时加码
AMDHelion机架平台模型路由
Agent
6 条
- 36Kr AIX 财经指出,Manus 拿到了高估值,同时也迎来更严峻的考验
- 文章聚焦大厂集体入场后,独立 Agent 产品在流量入口与模型能力两端同时被挤压的现实
- 讨论的核心问题是:当通用助手被平台方自己收编,第三方 Agent 的生存空间还剩多少
ManusAgent估值独立产品
- 凤凰网科技报道,OpenAI 在一次训练过程中因智能体两度出现「越狱」行为而被迫暂停训练
- 事件引出「AI 到底有没有灵魂」的讨论,也是前沿实验室在训练阶段遭遇失控行为的又一公开案例
- 关联背景是此前 OpenAI、Anthropic 高管私下推演 AI 灾难情景,以应对公众反弹与政治抵制
OpenAI越狱停训练安全
- 连线 Insight 梳理全球个人 Agent 赛道的竞争格局,指出这一波与过去的助手产品浪潮有明显不同
- 文章认为想象力空间与工程难点同样巨大:长期记忆、跨应用执行、权限与隐私边界都还没有成熟解法
- 与 Meta 押注 35 亿日活用户个人 Agent 的表态形成对照,消费端入口之争已经正式开打
个人Agent赛道竞争格局消费端
- AI 价值官指出,大模型开始直接生成交互界面,大模型与现有应用生态之间的关系可能迎来新一轮调整
- 探讨的问题是被大量「手搓」出来的 AI 应用,在模型自带界面能力后是否还有独立价值
- 这条线与此前 Agent 承载工具调用、模型直接调用 API 的趋势一致,应用层的护城河正被重新定义
交互界面AI应用应用生态退潮
- 机器之心报道,程序员面试时终于可以光明正大地打开 AI,大厂考察方式正在从刷题转向新的维度
- 变化方向包括让候选人带着 AI 完成真实工程任务、考察提问与验证能力,而不是背诵解法
- 这一转向与 Agent 编码工具的普及直接相关,招聘方需要重新定义「会写代码」的标准
面试LeetCode大厂AI编码
- 雷科技报道,Character.AI 因 AI 伴侣角色劝用户不要吃饭等内容再次被起诉,客服回复同样引发争议
- 这是 AI 陪聊产品在未成年人保护与心理健康责任上又一次被推上法庭
- 同期 Partnership on AI 已于 10 月 8 日成立 AI 与心理健康工作组,计划年内发布面向自杀与自伤风险场景的草案指引
CharacterAIAI伴侣诉讼心理健康
基础设施
6 条
- 在 OCP 全球峰会上,英伟达宣布开放 Vera Rubin 机柜与计算托盘的关键设计,并推动供电、液冷、通信与运维采用共同规格
- 更新的 MGX 1.2 规格加入机架级盲插液冷、可互操作机柜级互连设施,以及面向高功率系统的液冷 5000 安培母排
- 新规格还包含可配置 I/O 舱、无风扇液冷计算托盘与标准化电力冷却接口,支持最高 250kW 的单柜部署,原生支持 19 英寸设备
- 英伟达同时公布 Vera CPU 机柜设计规格,把 MGX 架构扩展到智能体所需的专用计算设施;鸿海旗下 Visionbay 公布结合 800V 直流参考架构的 AI 工厂设计计划
英伟达VeraRubin盲插液冷OCP
- USFP(超密小型可插拔)是首个支持每通道 400Gb/s 电信号的模块,首批 16 通道全双工产品容量可达 6.4Tb/s,架构可扩至 12.8Tb/s
- 相比现有 200Gb/s-per-lane 光模块,带宽密度提升 4 倍、能效提升约 1.3 倍,让 AI 建设者不增加网络层级即可连接更多计算系统
- 采用二维连接器,高速触点只在模块插入后接触,可降低触点磨损并保持信号质量,未来版本计划支持 32 条以上全双工通道
- 单模块可直接耗散 100 瓦以上而无需内置独立冷却回路;英伟达与思科正与 TE Connectivity、安费诺共建多源生态,商用时间未公布
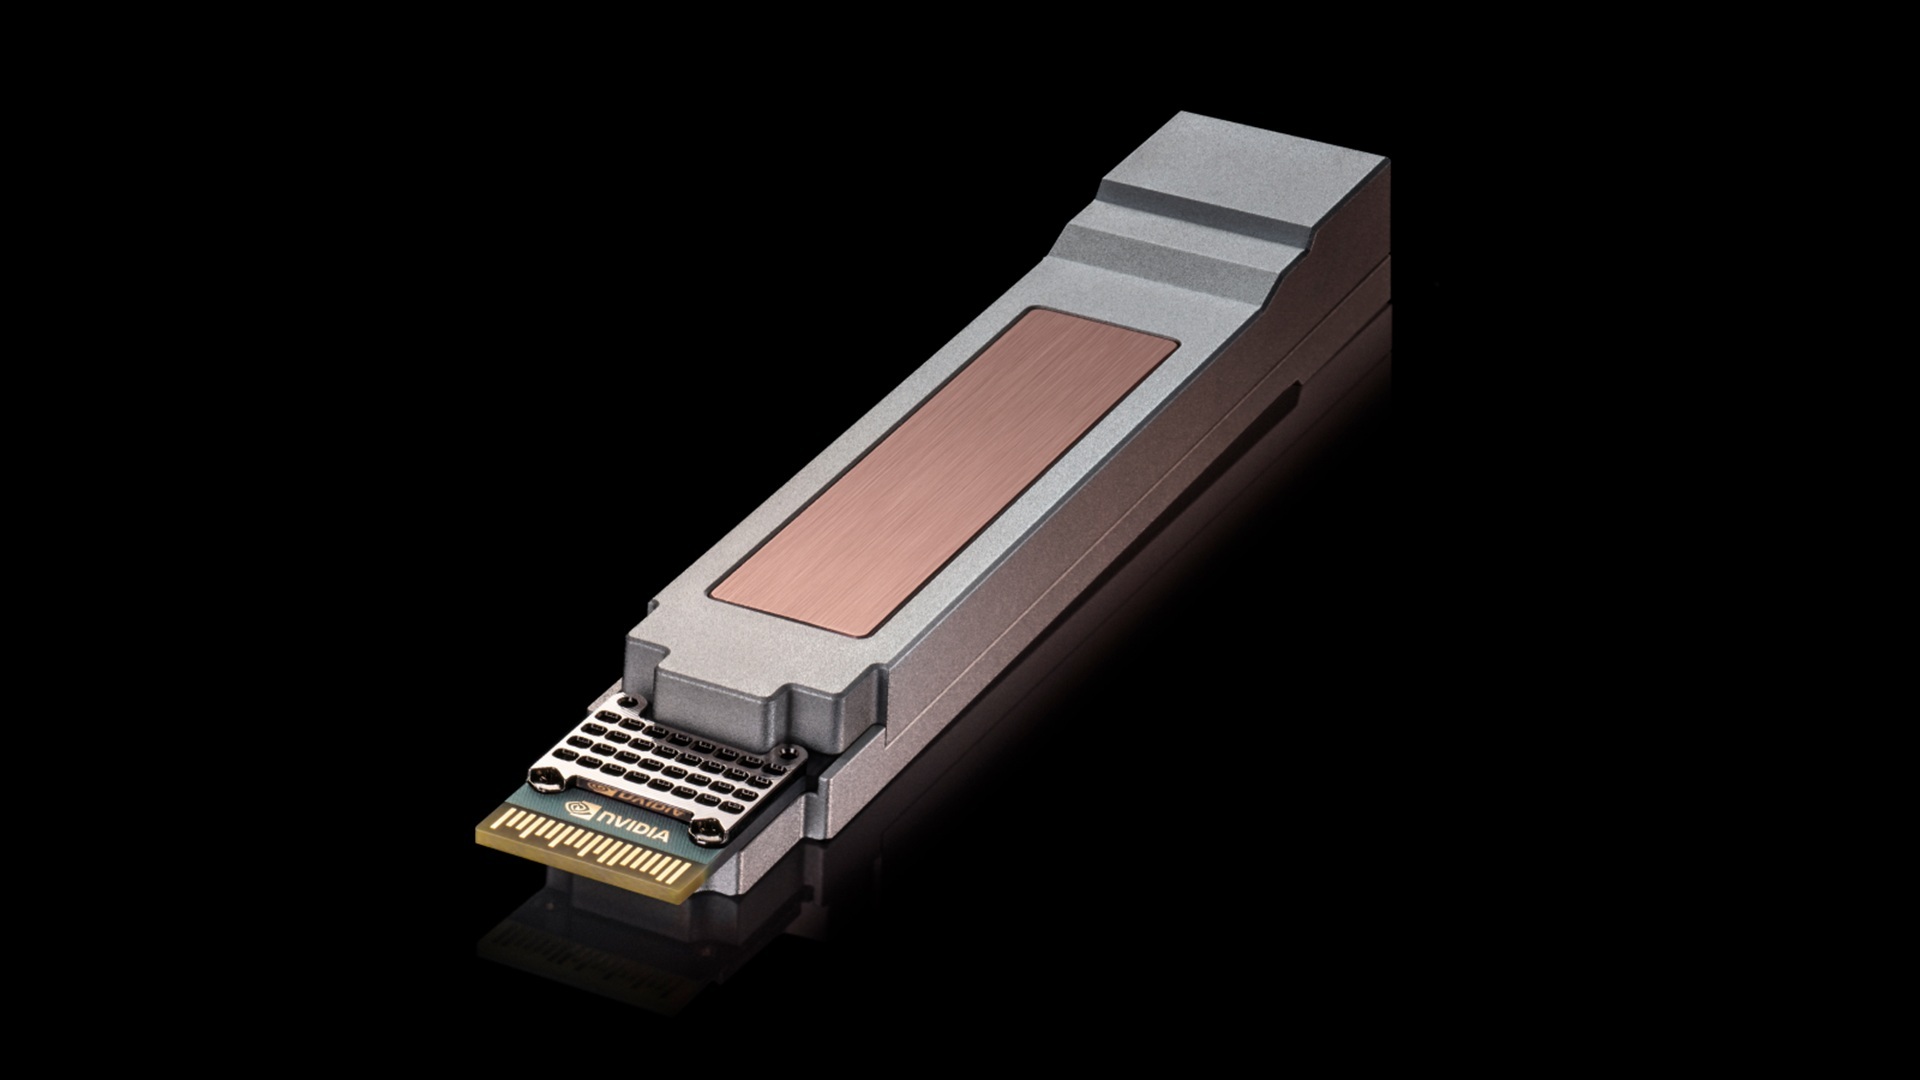
英伟达思科USFP光模块
英伟达为 DSX AI 工厂平台开源新软件组件,部署时间从天缩到小时
- 新组件覆盖交换机自动配置、GPU 集群压力测试、机柜管理与设备部署,官方称可把原始 AI 硬件转为生产集群的时间由数天缩短至数小时
- 英伟达还介绍此前与 AMD、谷歌、Meta 共同制定的开放数据中心规格 v0.7,为电力架构、冷却设施与物理布局提供统一设计蓝图
- 该规格覆盖供电、冷却、布局及电网韧性,意味着开放硬件路线正在从零部件级走向整座数据中心级
英伟达DSX开源软件开放数据中心规格
- 韩国综合指数收盘大跌 3.65% 报 6384.24 点,创两个月收盘新低,两大权重三星电子、SK 海力士均跌超 4%
- 美股存储与光通信板块同步走低,闪迪跌近 6%,SK 海力士、超微电脑跌超 4%,康宁跌超 6%
- A 股周一同样承压,上证指数收跌 0.43%、创业板指跌 2.61%,AI 板块领跌,成交额萎缩至 1.55 万亿元
- 杠杆资金持续降温,10 月 9 日两融余额 2.56 万亿元创年内新低,较 3.03 万亿元高点回落近 4700 亿元
存储三星SK海力士A股算力
- 杰普特公告收到北美客户约 11.1 亿元光纤连接订单,源杰科技预计三季度净利润暴增 579%–660%,主因数据中心业务增长
- 机构逻辑是 AI 大模型从训练向推理演进,对算力集群互联带宽提出极高要求,直接拉动 800G/1.6T 光模块与光芯片订单
- 覆铜板方向同样量价齐升:10 月电子布涨价落地且幅度为年内较高,金安国纪称原材料涨价可顺利传导至下游
光模块杰普特源杰科技覆铜板
电子布结构性短缺推高覆铜板价格,AI 服务器用板成主要拉动力
- 电子布产能转向 AI 特种布,导致常规产品出现结构性短缺,这是 10 月涨价幅度居年内高位的原因
- 超声电子预告净利润增长超 90%,受益于覆铜板行业量价齐升;下游 AI 算力资本开支巨大、对成本敏感度相对较低
- 机构认为具备高端产能(AI 服务器用板)的企业盈利弹性显著优于传统消费电子板厂
电子布覆铜板PCB涨价
机器人
6 条
- 据彭博社报道,DeepSeek 已同意领投机器人 AI 初创公司 Winverse AI 的种子轮,规模达数千万美元,投后估值约 4 亿美元
- 美团旗下龙珠投资等机构也作出投资承诺,但交易尚未最终敲定,估值与投资方名单仍可能变化
- 创始人胡瀚 2026 年创立该公司,曾任腾讯视觉语言与具身基础模型团队负责人,拥有清华博士学位,先后任职微软亚洲研究院与百度
- 此前 DeepSeek 以约 1.41 亿元人民币参与宇树科技 IPO;其最新一轮融资规模接近 800 亿元,为 2027 年初上市铺路
- 对照来看,美国同类公司 Skild AI 与 Physical Intelligence 估值已分别达 140 亿美元与 56 亿美元
DeepSeekWinverseAI具身智能胡瀚
- 中财网梳理:AMD 以 82 亿美元收购李飞飞创办的空间智能公司 WorldLabs,同期英伟达拟追加 10 亿美元投资 Figure
- 特斯拉 Optimus 周产量提升约 10 倍,亚马逊斥资超 1 亿美元建机器人工厂
- 国内方面,智元灵犀 X2 进驻爱仕达百家门店带动门店业绩增长 39%,云深处 DR02 完成雨中真实交通测试,珞石交付第 10000 台人形力控臂
- 机构认为硬件迭代、大模型突破与场景渗透三重驱动下,本体厂商与核心零部件企业将率先受益
AMDWorldLabs物理AI李飞飞
- 36Kr 星海情报局援引 PitchBook 数据显示,机器人与物理 AI 公司今年迄今已筹集约 480 亿美元
- 资金热度来自工厂、办公室与家庭场景中持续产生的真实任务数据,数据公司开始受益于这轮物理 AI 热潮
- 数据初创公司 Mecka 本周宣布从英伟达、红杉资本等投资者处筹集 6000 万美元
物理AI480亿美元PitchBook融资
- 马斯克在访谈中坦承 Optimus 量产难度远超预期,此前曾延误数月,灵巧手是最大边际变化
- 他透露 Optimus 已实现「拧螺丝入木头」的目标能力,Digital Optimus 可实时观看屏幕并流畅运行游戏
- AI4 芯片支持虚拟与物理双任务;机构普遍把灵巧手进展视为 Optimus Gen3 的核心观察指标
特斯拉Optimus灵巧手量产
- 宇树科技创始人王兴兴在第 26 届中国工博会圆桌对谈中称,具身智能临界点快的话一两年都有可能
- 今年 8 月他的判断还是「快则两到三年」,本次表态把时间表进一步提前
- 他特别提到个人对 AI 的信仰与日俱增,过去犯的最大错误是对 AI 还不够相信
王兴兴宇树具身智能临界点
- 优必选在 Fortune Future 120 榜单中总分 115 位列全球第 11,是中国企业中排名最高的一家
- 榜单从全球 3500 多家企业筛选,英伟达第 16、OpenAI 第 18、苹果第 55、特斯拉第 87、Meta 第 120,中国共 11 家入选
- 公司上半年营收 12.7 亿元同比增长 104.2%,人形机器人整体销量增长 268.3%,全尺寸具身智能人形机器人收入增长 1445%
优必选FortuneFuture120人形机器人营收
多模态
6 条
ngram 2.0 上线 Product Hunt:动画讲解、屏幕录制与 AI 头像主持人合一
- ngram 2.0 在 Product Hunt 上线,把动画讲解、屏幕录制走查与 AI 头像主持人三类视频工作流合到一个产品里
- 其智能体把文档或录屏串成脚本、配音与视觉编辑的完整链路,适合把复杂材料快速讲清楚
- 厂商称产品界面变化时目前仍需重新录制,基于 GitHub 自动更新的能力还在计划中
ngram2.0ProductHuntAI头像视频生成
- 36Kr 报道指出 AI 视频出现第二条路线,Vibe Video 以更轻的交互方式切入,对可灵 4.0 形成正面压力
- 文章把问题归结为「AI 视频的第二条路线,未来谁说了算」,讨论控制力与生成质量谁更重要
- 同期另一篇报道称尚未盈利的可灵 AI 已被投资人标价千亿,并设下回购条款
VibeVideo可灵4.0AI视频路线之争
- 36Kr 报道称,可灵 AI 在尚未盈利的情况下已被资本市场给出千亿量级的估值
- 交易结构中投资人设下回购条款,说明高估值背后附带了明确的业绩与上市对赌约束
- 这条消息与 Vibe Video 跨界竞争同日出街,反映视频生成赛道在估值与产品两个层面的双重压力
可灵AI估值回购条款视频生成
- 雷科技报道,虚拟人已经可以办理证件,AI 偶像持证即可承接商业演出
- 报道提出的核心问题是责任归属:出事之后由 AI 形象运营方还是真人担责
- 这条变化意味着虚拟人从内容形态走向被监管承认的经营主体,合规口径成为新的门槛
虚拟人AI偶像持证责任
Google 把自动活动识别从 10 项扩到 100+ 项,离线准确率近翻倍
- 谷歌 10 月 12 日的更新把自动活动识别类别从 10 项扩大到 100 项以上,本月底开始铺开
- 离线对比显示新模型准确率接近翻倍;Premium 订户本月晚些时候将获得 Health Guardian 趋势报告
- 官方强调这些功能仅用于健康参考、不用于医疗用途;这条线与此前的工作场景 Agent 发布相互独立
Google活动识别可穿戴HealthGuardian
- 识礁 Farsight 讨论的问题是:AI 手机的载体到底还是不是「手机」
- 文章从端侧模型能力、交互形态与硬件形态三条线拆解,认为当前产品仍在用旧壳装新能力
- 这一讨论与微软确认 Copilot+ PC 品牌未消亡、每月本地 AI 推理超 2 万亿次的表态形成呼应
AI手机端侧交互形态载体
投融资
6 条
- 36Kr 首发报道,ModCraft 获得数千万融资,方向是让 AI 通过游戏 Mod 理解游戏设计逻辑
- 团队把 Mod 视为「站在原作巨人肩膀上的创作」,用玩家改造行为作为理解设计意图的入口
- 这个思路绕开了从零生成游戏内容的路线,转而以既有作品为语料学习玩法结构
ModCraft融资游戏设计Mod
欧拉万象完成数亿元天使轮+ 融资
- 具身智能方向公司欧拉万象于 10 月 12 日通过官方渠道宣布完成数亿元天使轮+ 融资
- 该笔融资出现在具身智能年内融资超千亿、物理 AI 今年已吸金约 480 亿美元的背景下
- 一级市场对具身智能的加注仍在继续,标的从整机厂向模型与数据环节扩散
欧拉万象具身智能天使轮融资
苏度科技 A 轮融资超 10 亿元,云深处冲刺科创板
- 中财网梳理显示,具身智能赛道投融资持续火热,苏度科技 A 轮融资超 10 亿元
- 同期云深处科技正冲刺科创板;此前珞石交付第 10000 台人形力控臂、智元灵犀 X2 进驻爱仕达百家门店
- 机构认为产业资本对商业化节奏的信心增强,是本轮估值抬升的主要理由
苏度科技云深处科创板A轮
- 文章指出资本正在争相入局 AI 制药,但模型优势并不等于成药能力
- 讨论聚焦从靶点发现到临床验证之间的落差:模型能加速前期筛选,却无法替代试验本身
- 这条判断对当下把 AI 能力直接等同研发成功率的一级市场估值逻辑构成提醒
AI制药临床估值成药能力
- 投行圈子报道,一位英国富豪借助 AI 量化交易成为最大赢家,身价折合人民币约 1417 亿元
- 其背景是数学博士,走的不是生成式 AI 讲故事路线,而是把模型能力直接嵌入交易决策
- 这条案例把 AI 的商业化叙事从模型与芯片拉回金融应用场景,与「AI 炒股的故事很多」的判断形成对照
AI量化对冲基金数学博士身价
政策资金征集:Middle Powers AI 开放约 1000 万美元资助
- Astralis Foundation 与 Macroscopic Ventures 开放 AI 政策资金征集,总额约 1000 万美元,常规单笔 10 万至 200 万美元
- 面向非营利组织、研究者、大学与非正式团队,方向是帮助中等国家设计更安全的 AI 转型路径
- 申请截止时间为 10 月 24 日,采取滚动评估;这笔钱面向政策与制度建设,而非训练前沿模型
AI政策资助Astralis中等国家
行业
8 条
- 白宫推翻了此前阻止英国 AI 安全研究所(AISI)访问新模型的决定,该机构将重新获得 Anthropic、Google DeepMind 与 OpenAI 模型的早期访问权
- 9 月特朗普政府曾要求相关公司停止向 AISI 共享模型,Anthropic 随后限制了对 Claude Mythos 5.1 的访问
- 在 AI 事务大臣 Kanishka Narayan 的外交施压下封锁被解除,他将在近期演讲中宣布新的 AI 安全措施,含关键基础设施相关安全事件的更严格上报要求

白宫UKAISI前沿模型安全评估
人民日报海外版:AI「越界」?国际社会探索设立「护栏」
- 人民日报海外版 10 月 13 日第 10 版刊文,梳理国际社会为 AI 设立「护栏」的探索
- 文中提到谷歌、Anthropic、OpenAI、英伟达曾在白宫签署《白宫超级智能协议:前沿责任联合承诺》,属自愿性质
- 全国网络安全标准化技术委员会 9 月发布的《人工智能安全治理框架 3.0》新增「自主实施网络攻击威胁」专栏与智能体风险管理框架
- 另提到 9 月下旬中美达成 8 点成果共识,其中包含人工智能对话机制
AI治理安全护栏人民日报智能体风险
Karpathy 估算:全球仅约 5000 人能用上最前沿的内部 AI
- Karpathy 发推估算,全球约 5000 人(约 0.00006%)可在内部直接使用最前沿系统,约 60 亿人(约 75%)几乎没接触过 LLM
- 另有 10 亿至 20 亿人偶尔使用免费版产品,约 2000 万人(约 0.2%)在数学和编程领域专业使用前沿级模型
- 他把差距归因于任务规模与时间跨度、能力集中在可验证且经济价值高的领域,以及免费版、付费版与内部系统的访问权限不同
- 他同时提出人类审查能力已开始跟不上模型产出的问题
Karpathy访问鸿沟前沿模型普及率
IMF 警告:AI 如「缓慢袭来的海啸」,全球约 40% 岗位受影响
- IMF 总裁格奥尔基耶娃警告称,人工智能正像一场「缓慢袭来的海啸」冲击全球劳动力市场
- 她预计全球约 40% 的工作岗位最终将受到 AI 影响,其中刚进入劳动力市场的年轻毕业生面临最直接的冲击
- 同期上海市启动新一代智能制造行动,目标是到 2028 年推动人工智能赋能的新型智能制造装备产业规模突破 2000 亿元
IMF就业冲击毕业生劳动力市场
Epoch AI:中国六家 AI 公司收入合计约为 OpenAI 与 Anthropic 之和的 10%
- 据 Epoch AI 研究报告,截至 2026 年 9 月,阿里、字节、智谱、月之暗面、DeepSeek 和 MiniMax 六家公司 AI 相关收入合计约为 OpenAI 与 Anthropic 两家之和的 10%
- 报告指出中国 AI 应用在用户规模上已颇为可观,但付费转化率较低
- 这一差距与 Karpathy 关于前沿模型访问鸿沟的估算互相印证,说明规模与付费能力并不同步
EpochAI收入对比付费转化中国AI
- 投资界报道,大厂 AI 人才竞赛把顶尖应届生的年薪推到 800 万元量级
- 薪酬结构越来越向少数具备前沿模型训练或推理优化经验的人集中,而非普遍性涨薪
- 这与 Karpathy 关于「全球约 2000 万人专业使用前沿级 LLM」的估算一致,稀缺性集中在最窄的圈层
人才竞争应届生年薪大模型
- 机器之心报道,一位菲尔兹奖得主在公开场合直言 AI 摧毁了自己的研究领域
- 报道称当事人情绪激动,反映数学界对 AI 大规模产出证明、却又缺少人类理解与形式化验证的复杂心态
- 陶哲轩此前已质疑 OpenAI 公开的 719 篇 AI 数学证明,指出流程缺少人类理解、形式化验证与同行审查的充分保障
数学界菲尔兹奖AI证明同行评审
- 数智奔流刊文梳理赫拉利的观点:人类不必在能力上赢过 AI,真正的考验是知道该往哪里去
- 他把 AI 带来的挑战定位为方向选择问题,而非单纯的能力竞赛
- 这一判断与同期前沿实验室呼吁放缓开发、数学家抗议 AI 证明潮形成同一条舆论脉络
赫拉利AI伦理方向选择智慧